StartseiteExpertise03 · KI-Integration
KI-Integration
RAG-Pipelines, Embeddings und Vektorsuche mit pgvector — produktiv im Einsatz, nicht als Demo. Diese Seite zeigt, woran das scheitert, wie ich es gebaut habe und woran du es nachprüfen kannst.
 KI-generiert
- Bereich
- 03 von 04
- Stack
- 11 Technologien
- Referenz
- KI-Exposé-Generator
 KI-generiert
Die Ausgangslage: die Suche findet nichts
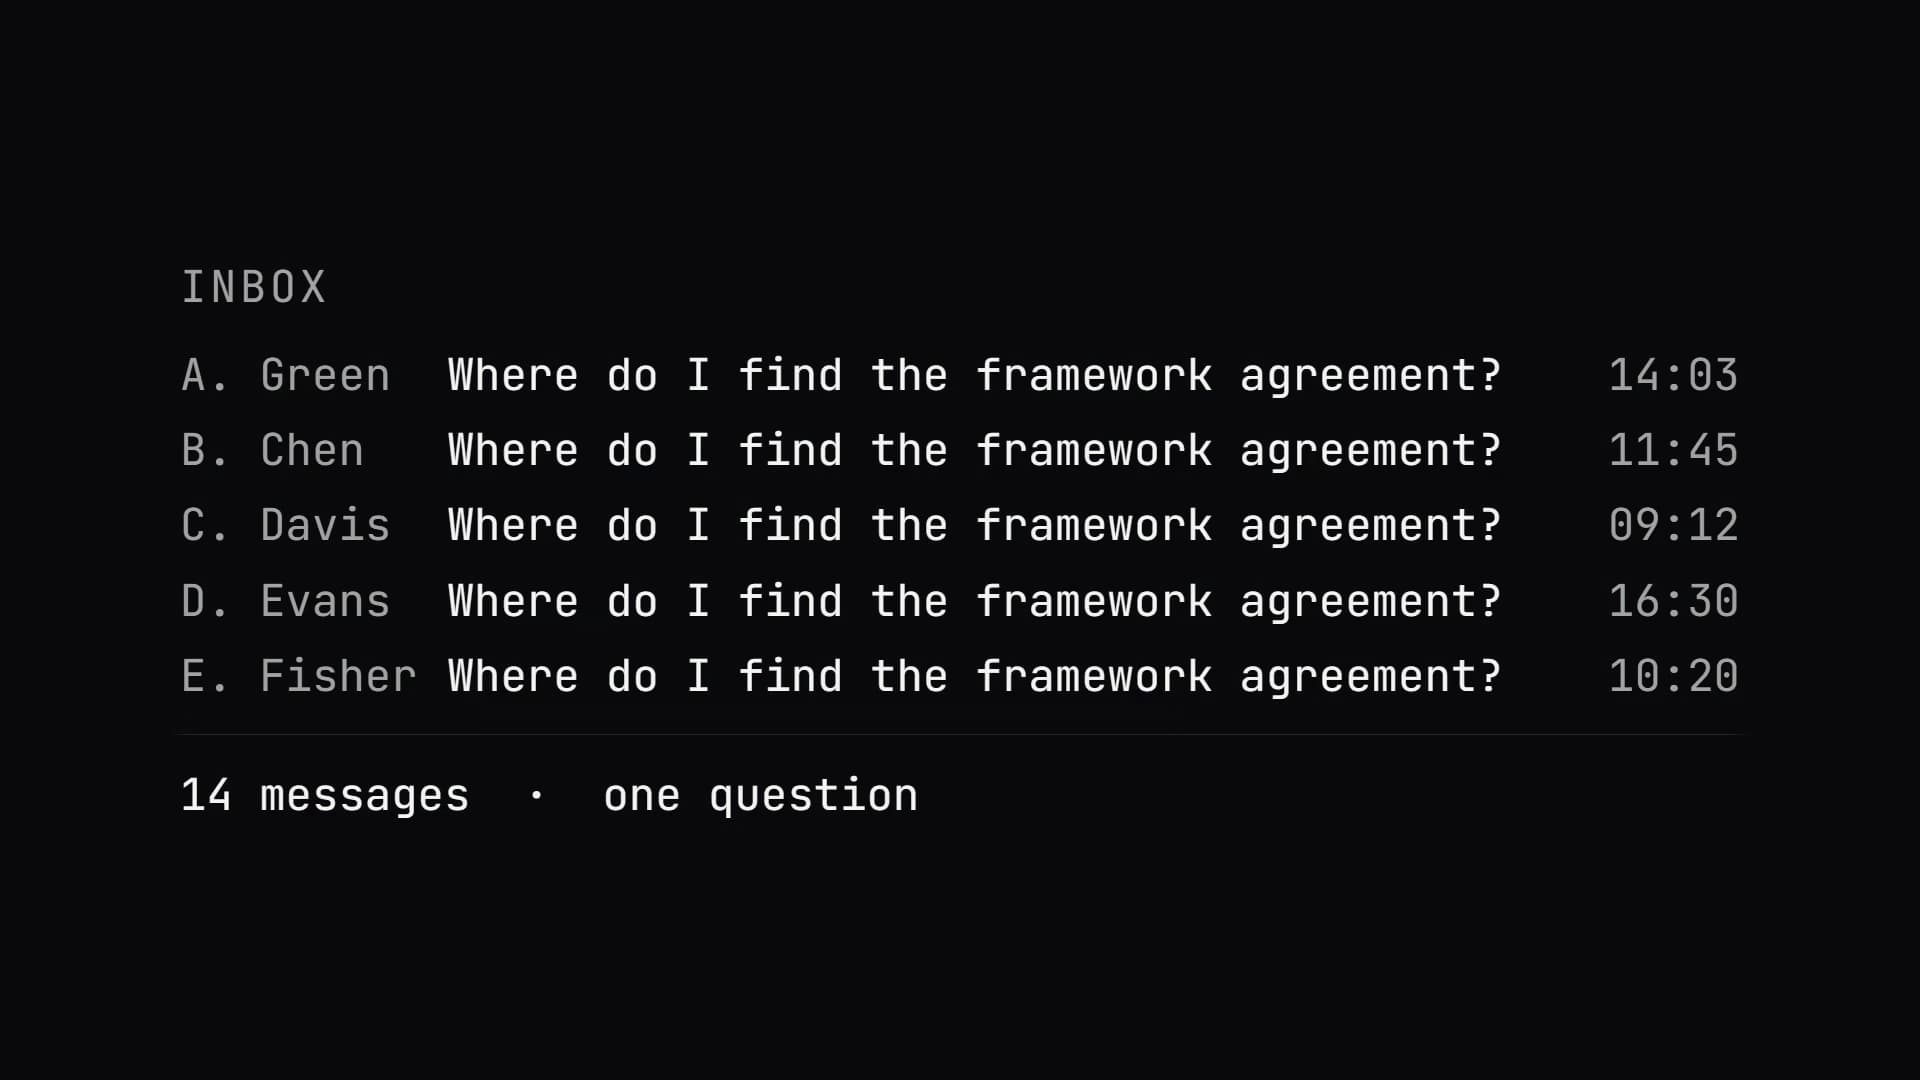
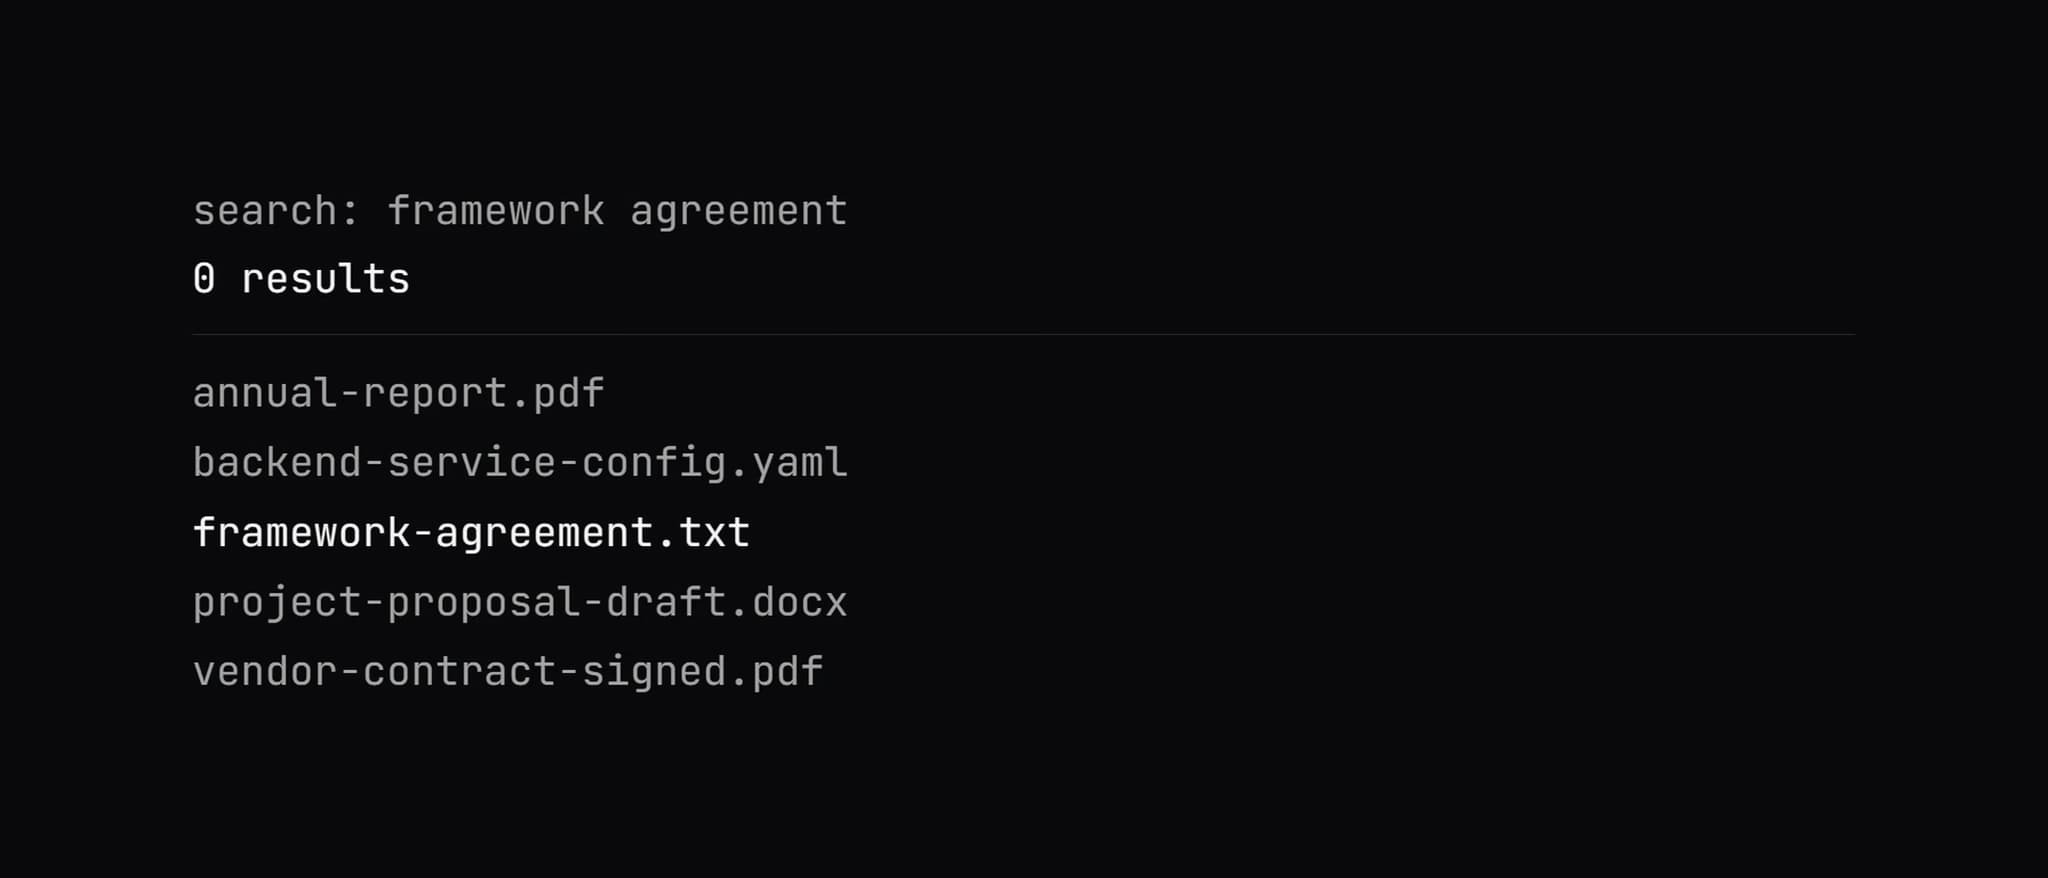
Das Wissen liegt da — in PDFs, Tickets und auf Laufwerken — aber niemand findet es. Die Suche findet Wörter, nicht Antworten; also fragt man den Kollegen, und der fragt den nächsten.
 KI-generiert
Arbeitsweise
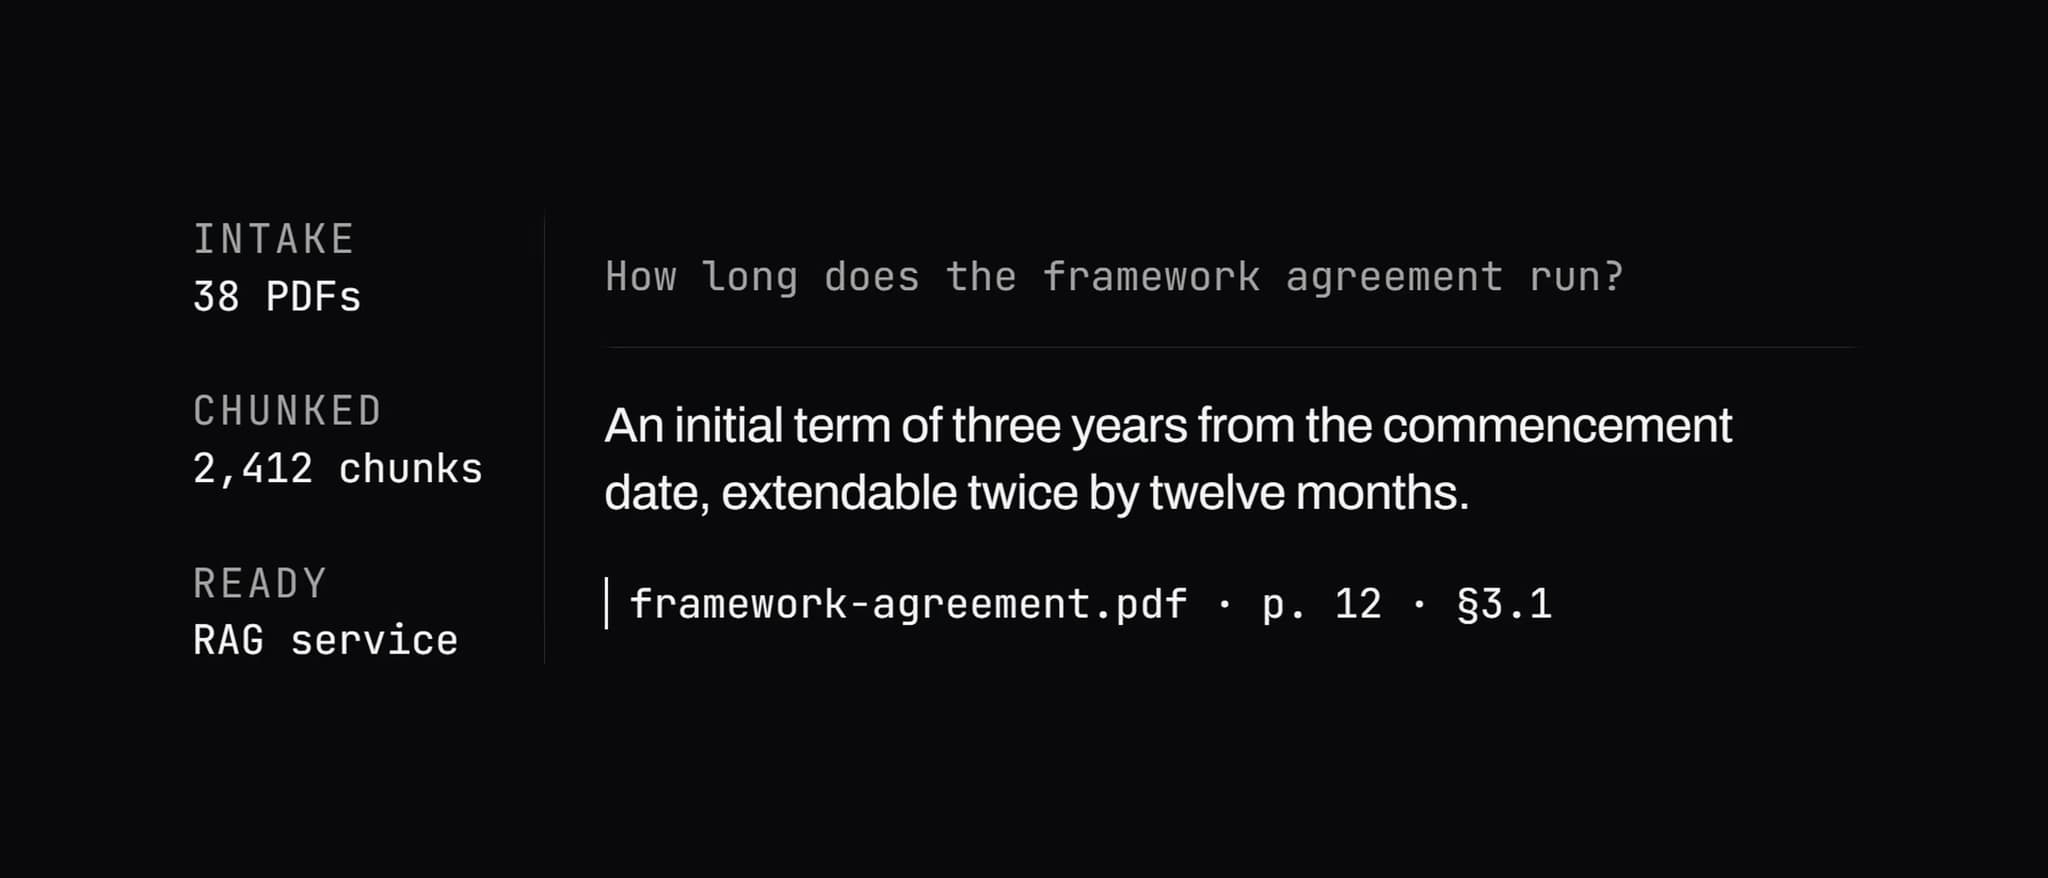
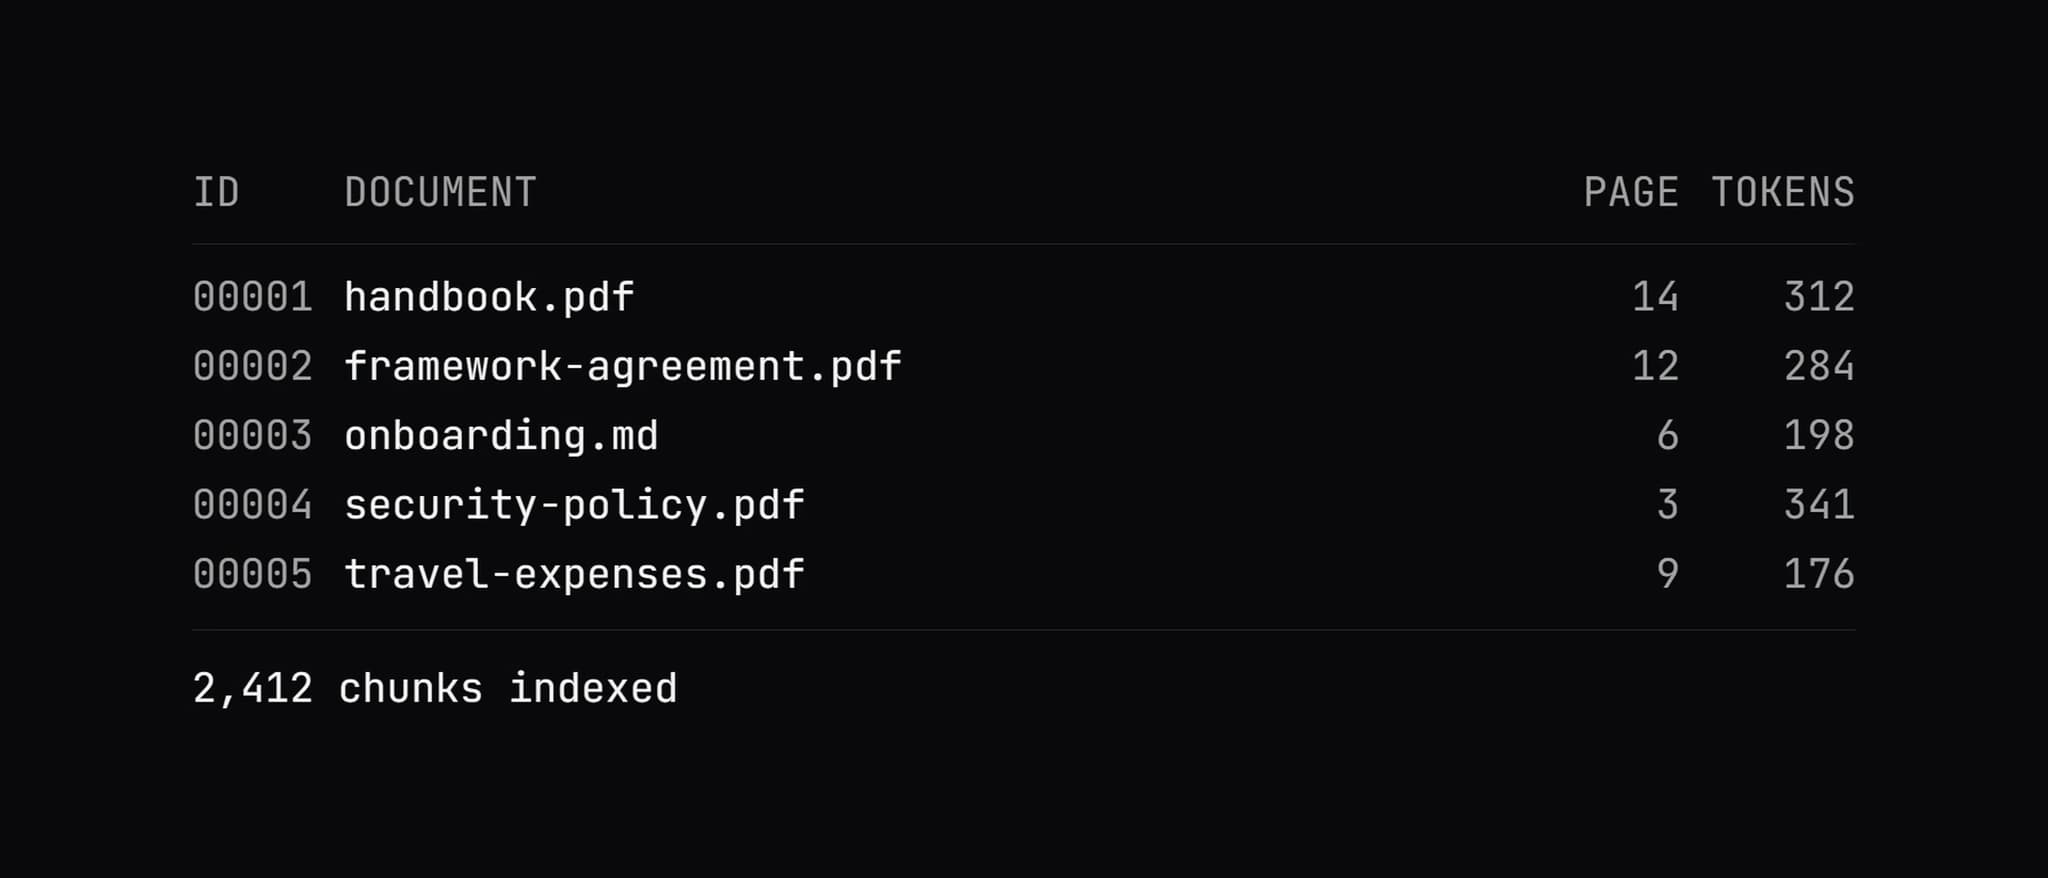
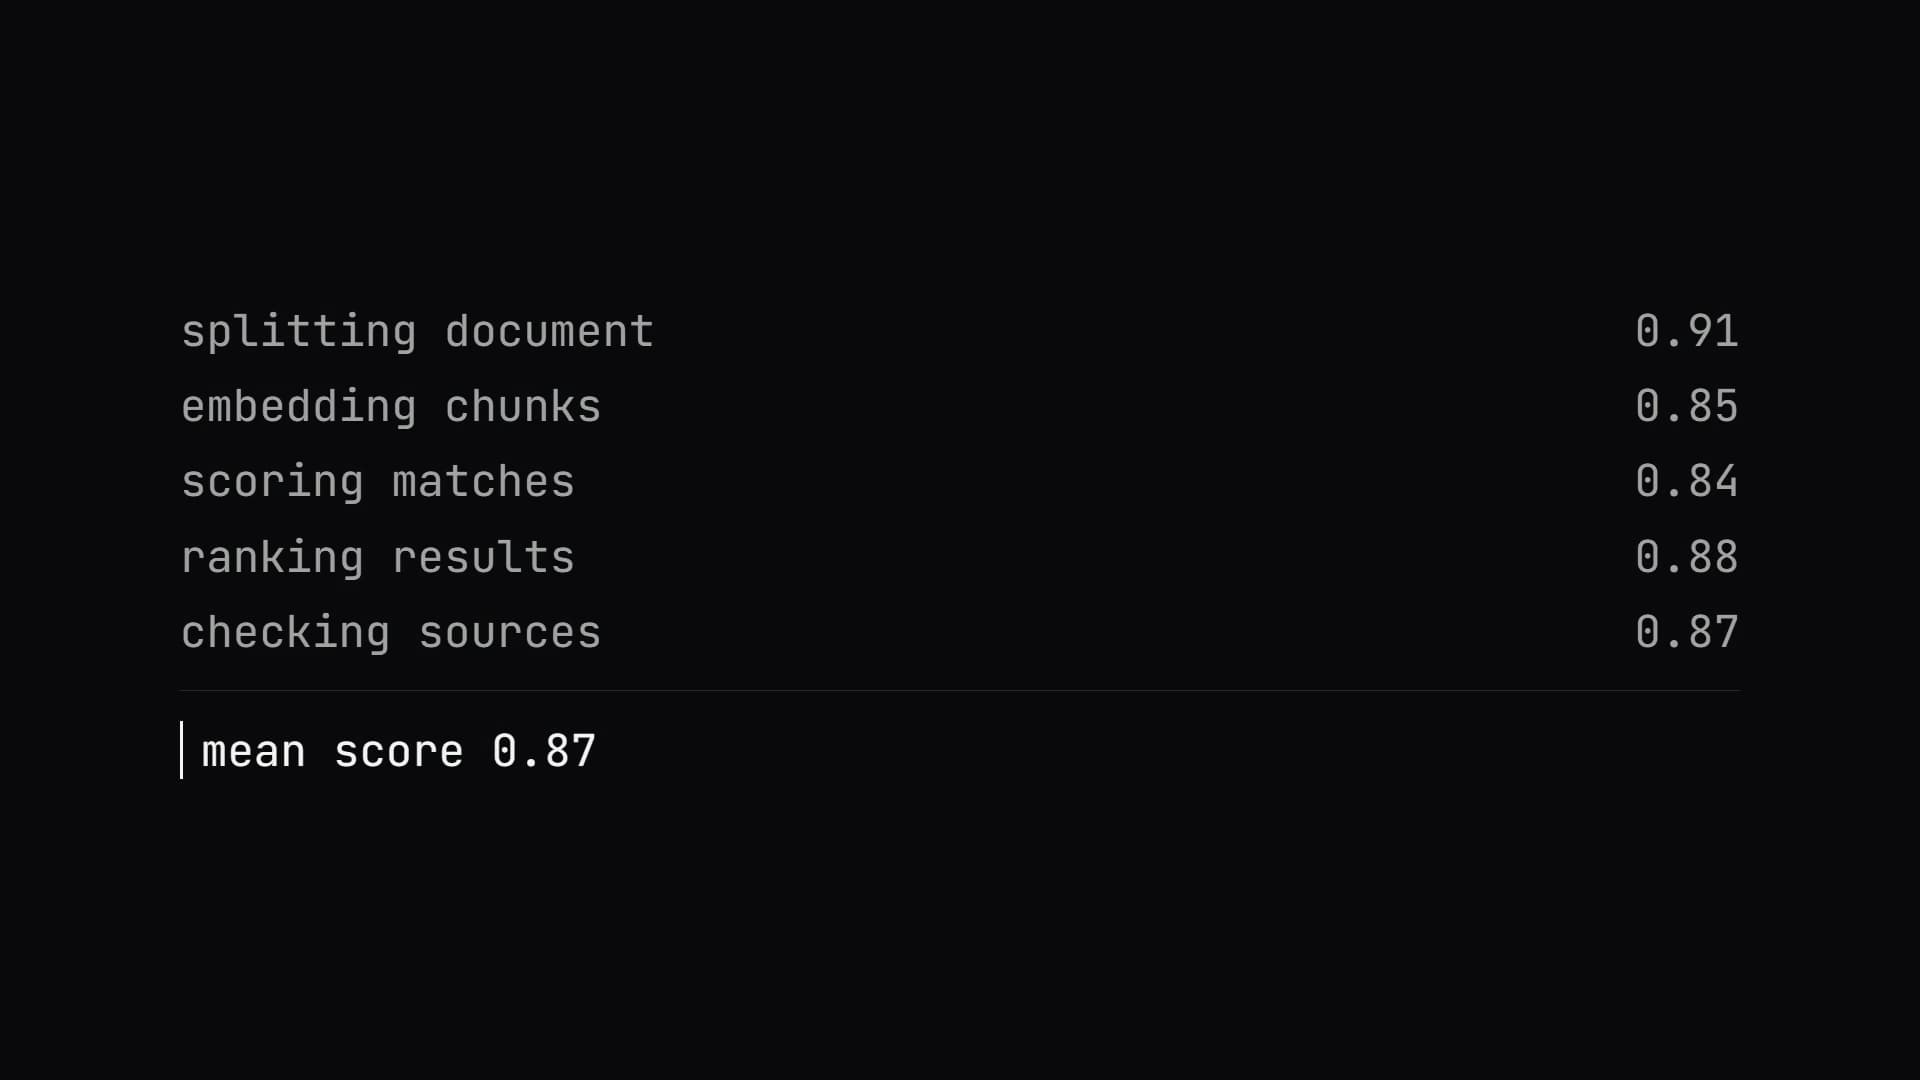
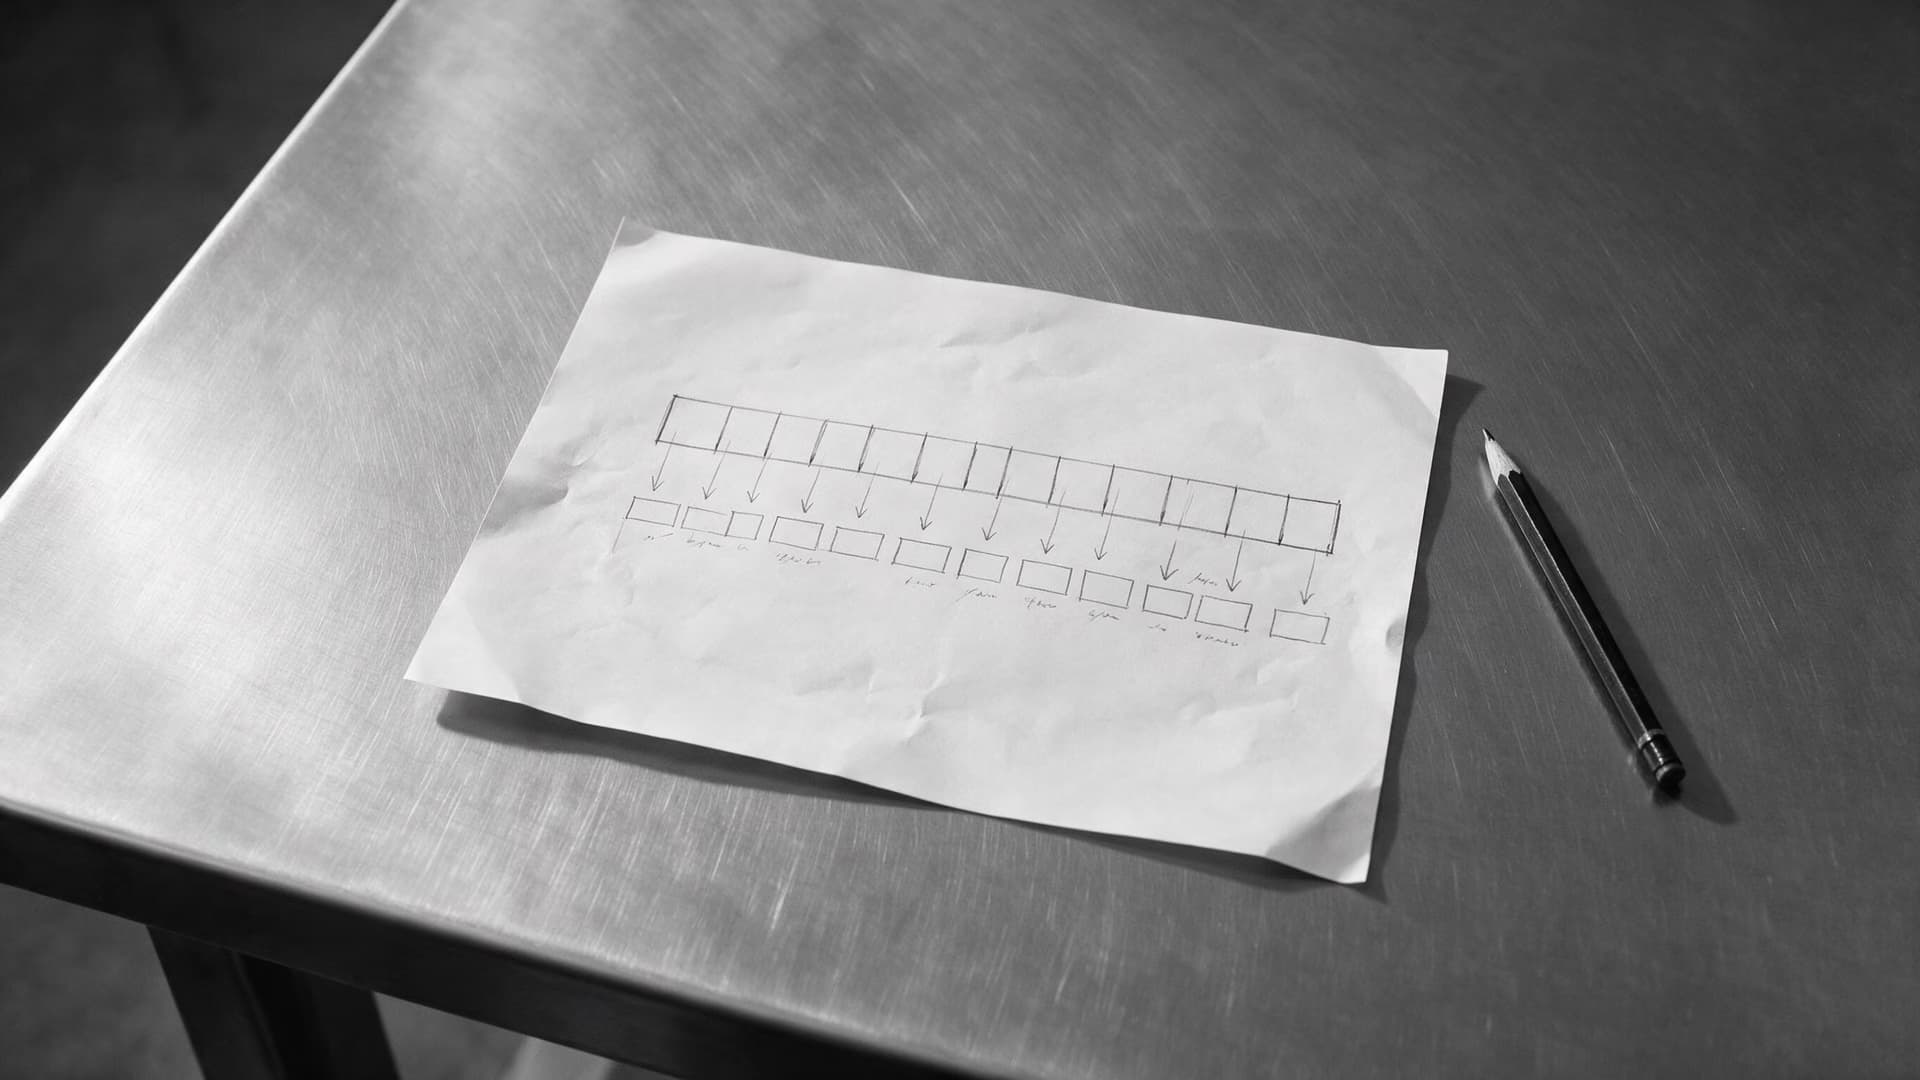
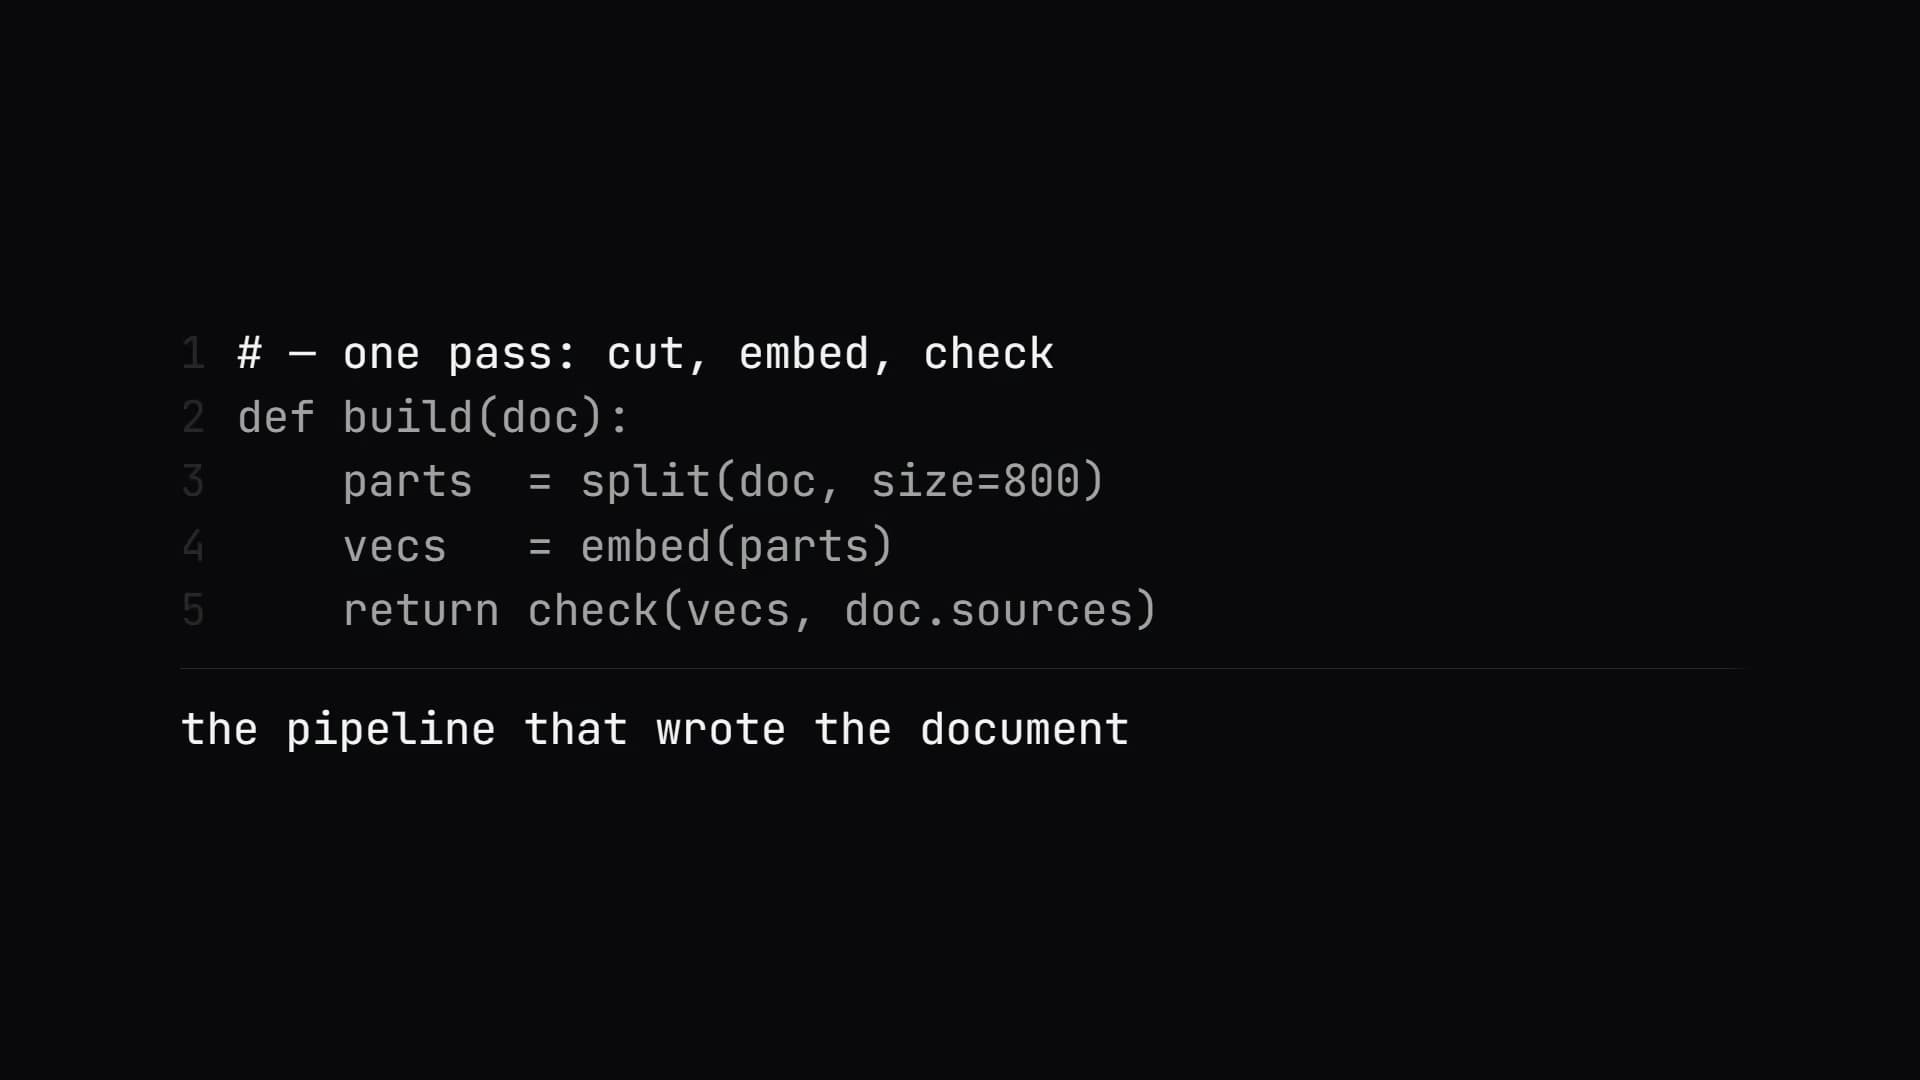
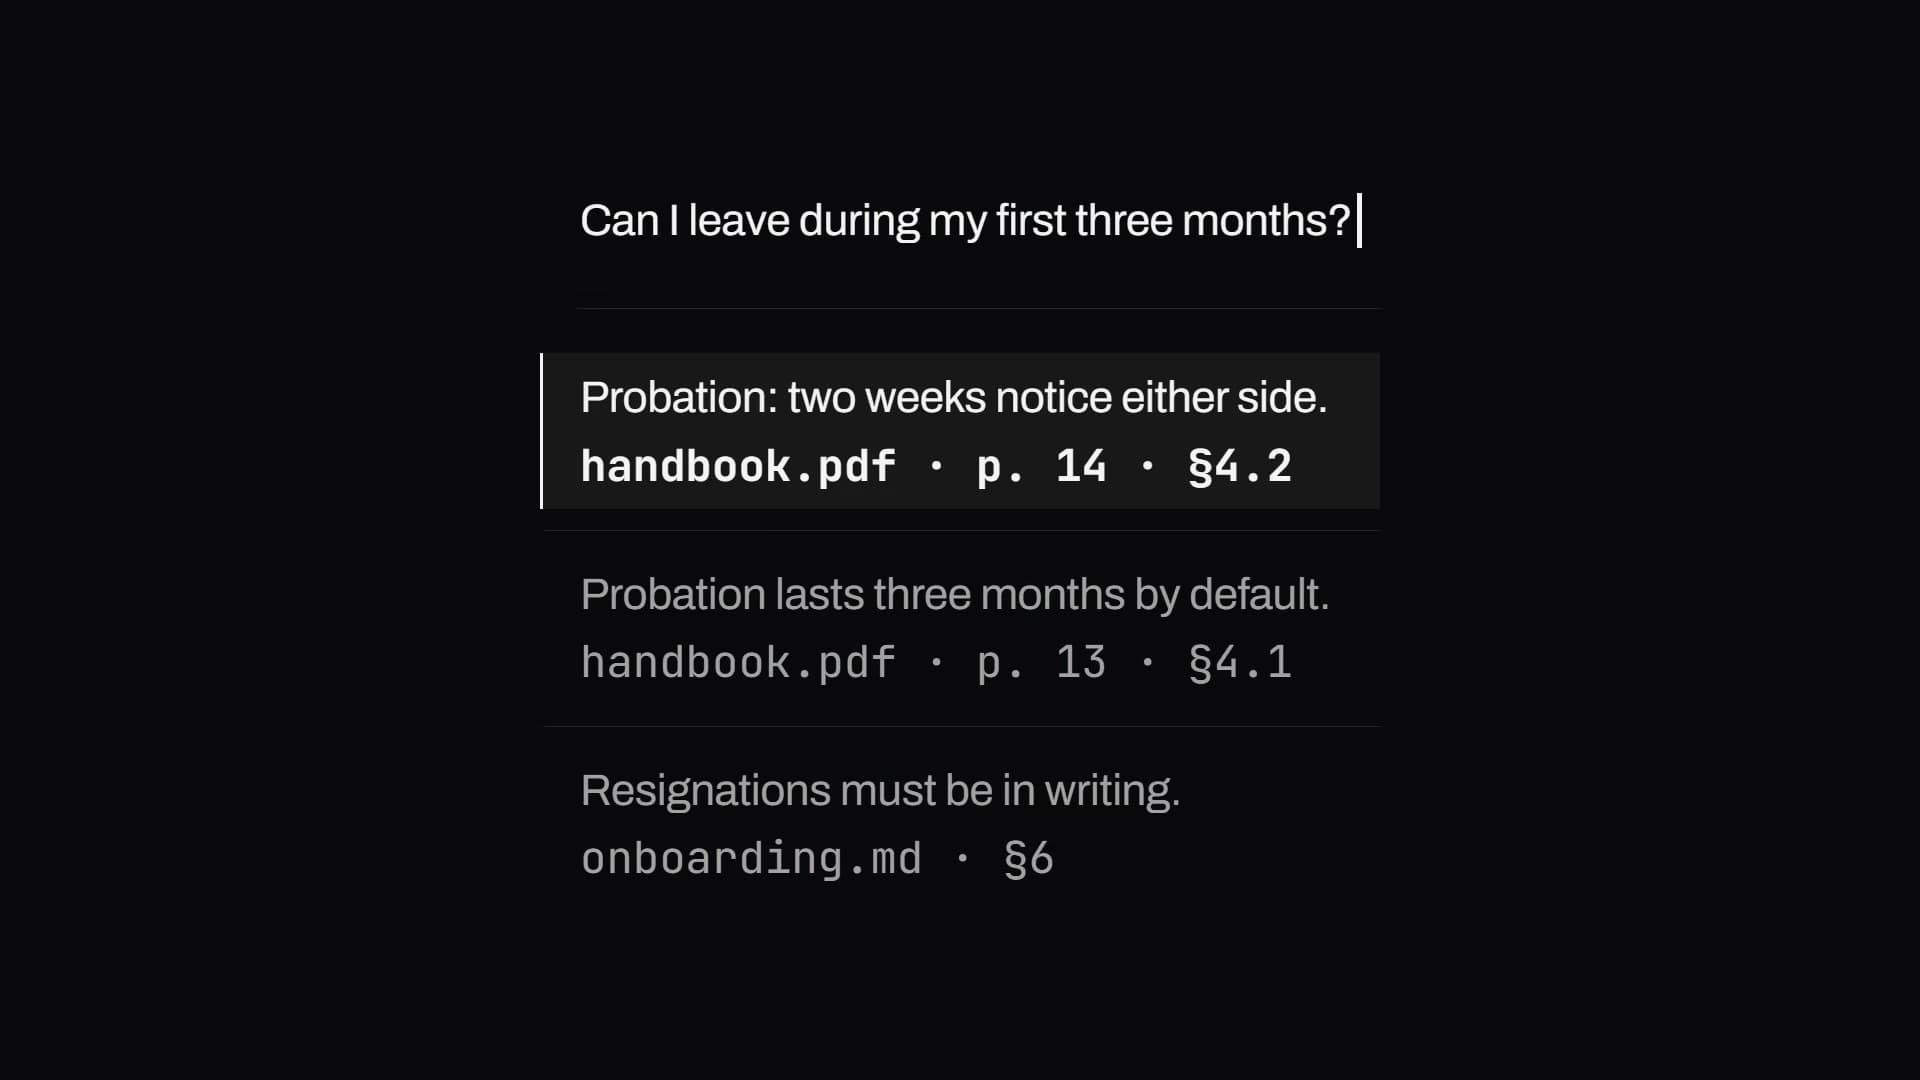
Erst der Bestand, dann das Modell: Dokumente werden an ihren Überschriften geschnitten, eingebettet und mit Volltext kombiniert. Getestet wird gegen echte Fragen aus dem Alltag — erst über 90 % Treffer@3 geht es in Betrieb.
 KI-generiert
BelegeDavor und danach2 Exponate
 KI-generiert
 KI-generiert
Das Referenzprojekt zu diesem Bereich
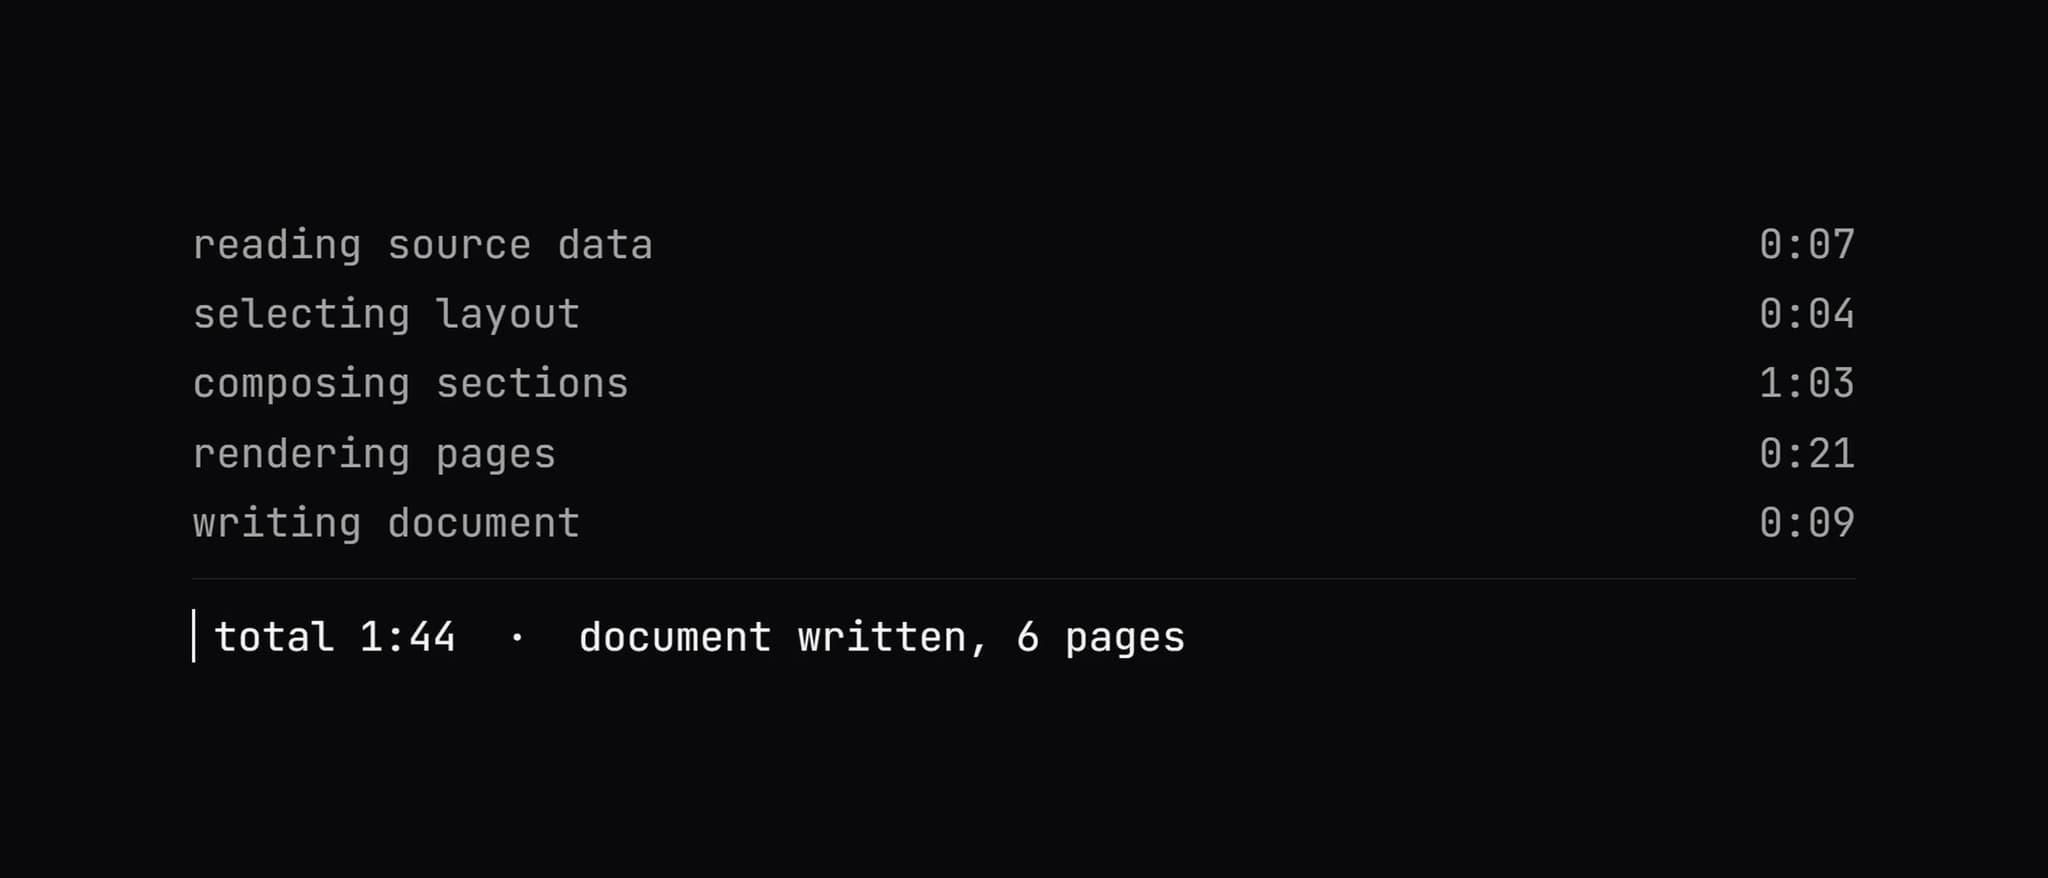
Eine Fähigkeit ohne Projekt dahinter ist eine Liste von Technologien. Das hier ist das Projekt — mit der Zahl, die dabei herauskam, und der Fallstudie, in der du sie nachlesen kannst.
Recruiting · KI
3 Min
pro Exposé · vorher 45
Exposés, die sich in drei Minuten selbst schreiben
Next.js TypeScript PostgreSQL pgvector RAG Claude / GPT / Gemini AWS (S3, Lambda) Docker
 KI-generiert
 KI-generiert
Woran ich gearbeitet habe
Vier Arten von Arbeit, jede mit dem einen Bild, das sie prüfbar macht. Nummeriert zum Draufzeigen — nicht, weil eine auf die andere folgt: jede steht für sich.
- 01
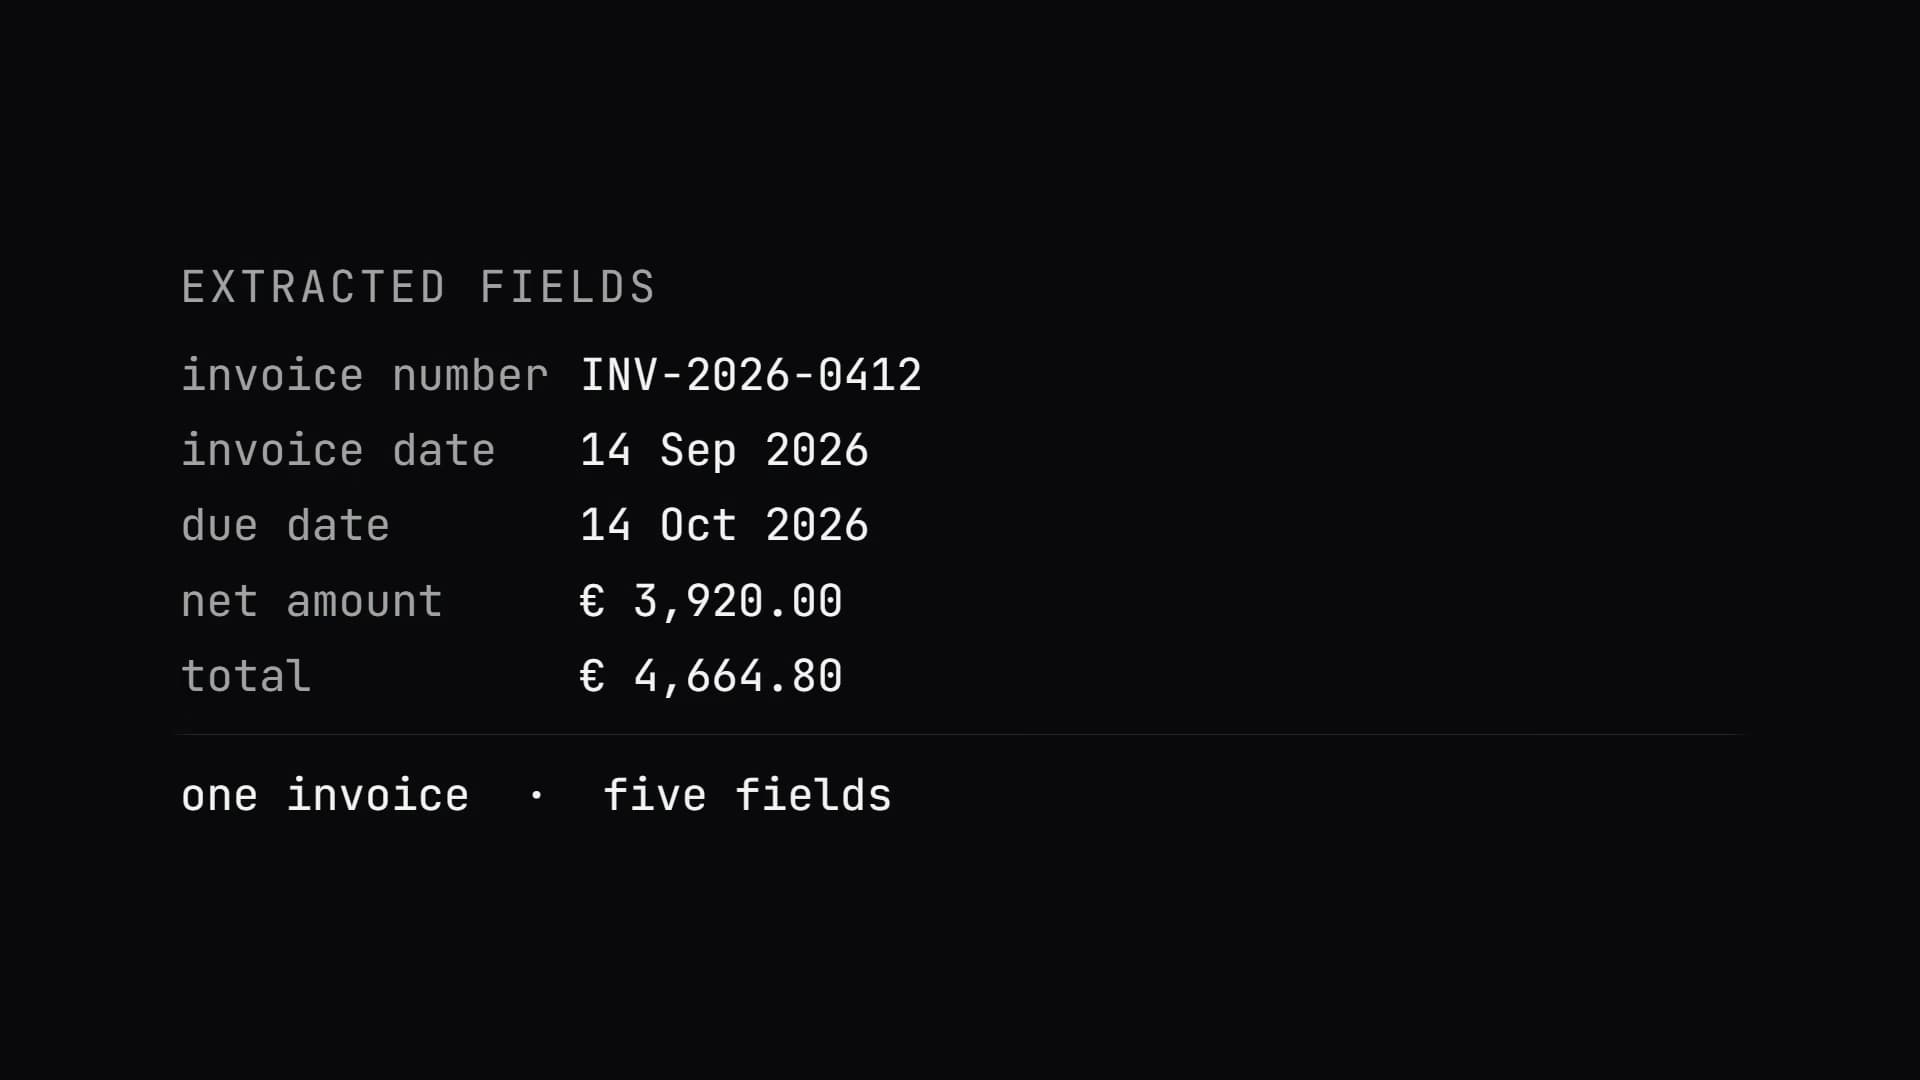
Dokumentenverarbeitung und automatisches Parsen
 KI-generiert
- 02
Semantische Suche über eigene Datenbestände
- 03
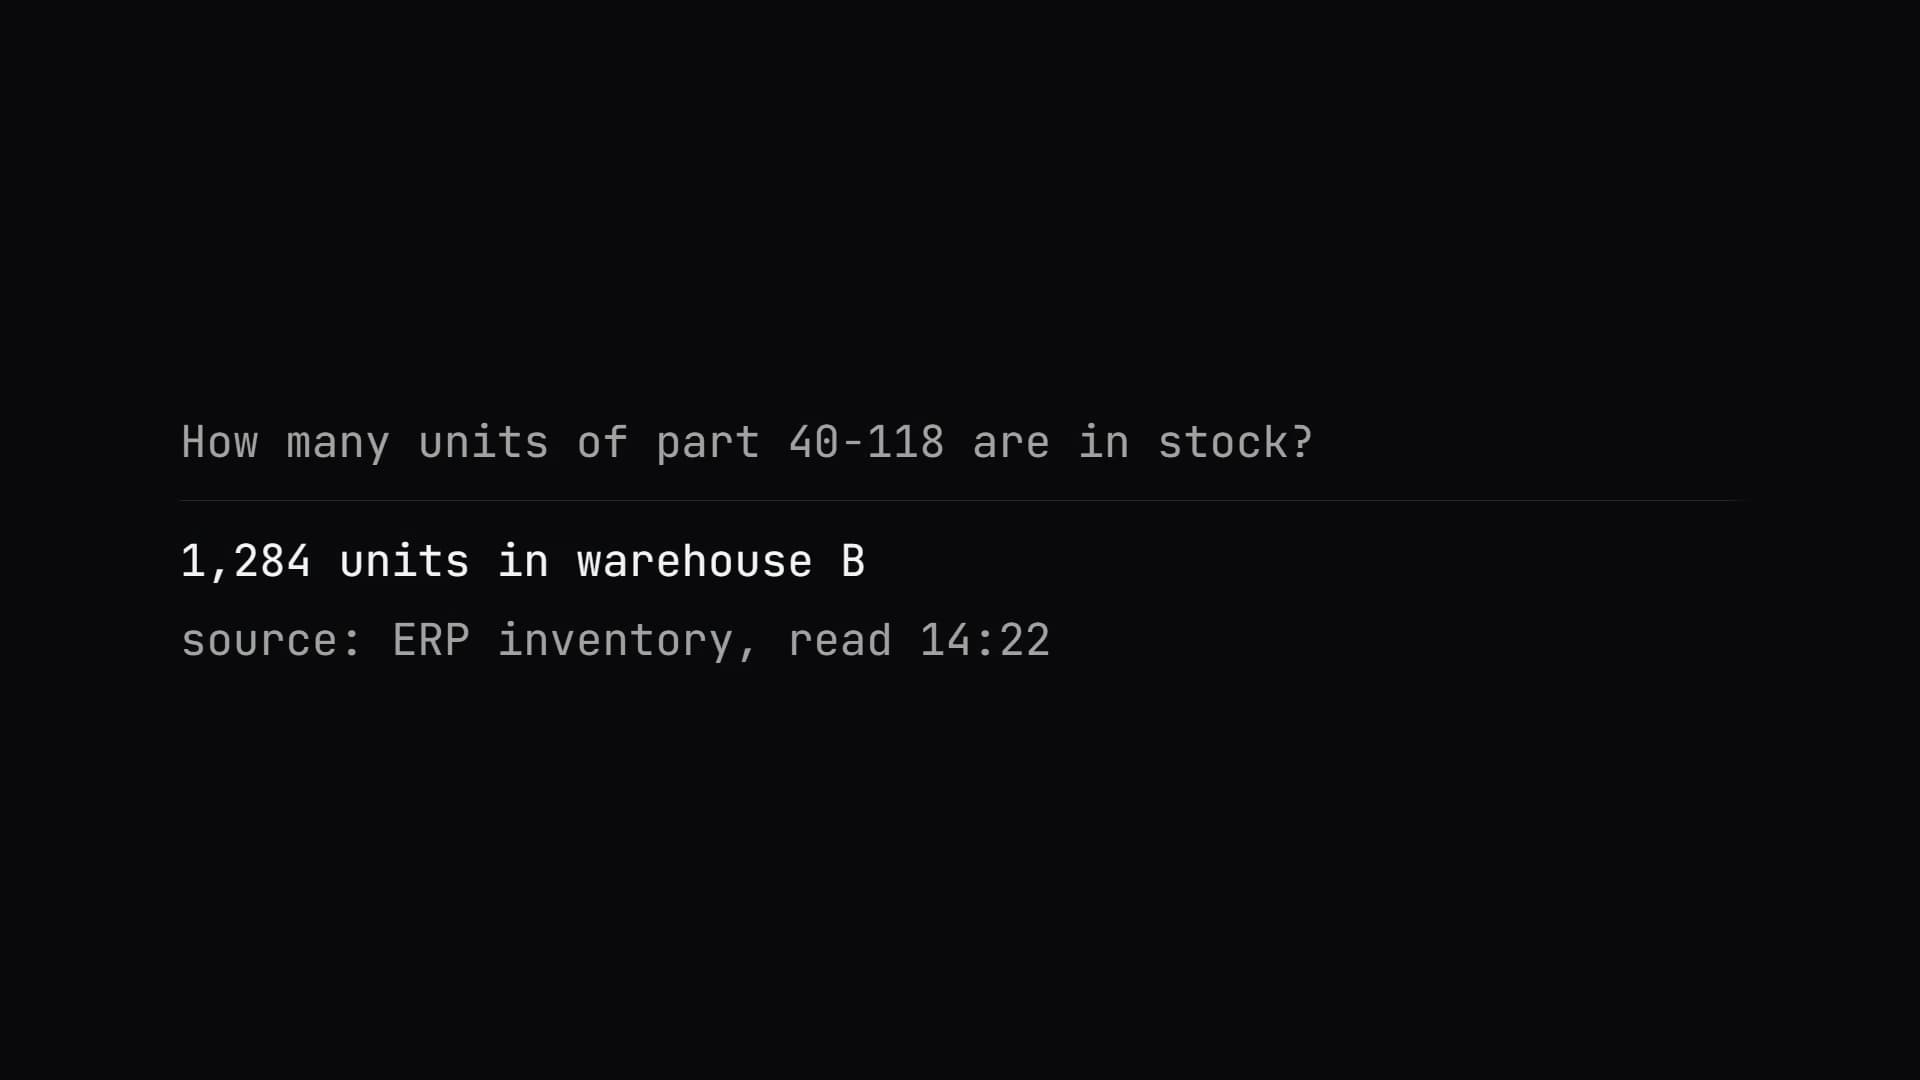
Chat- und Voicebots mit Anbindung an bestehende Systeme
 KI-generiert
- 04
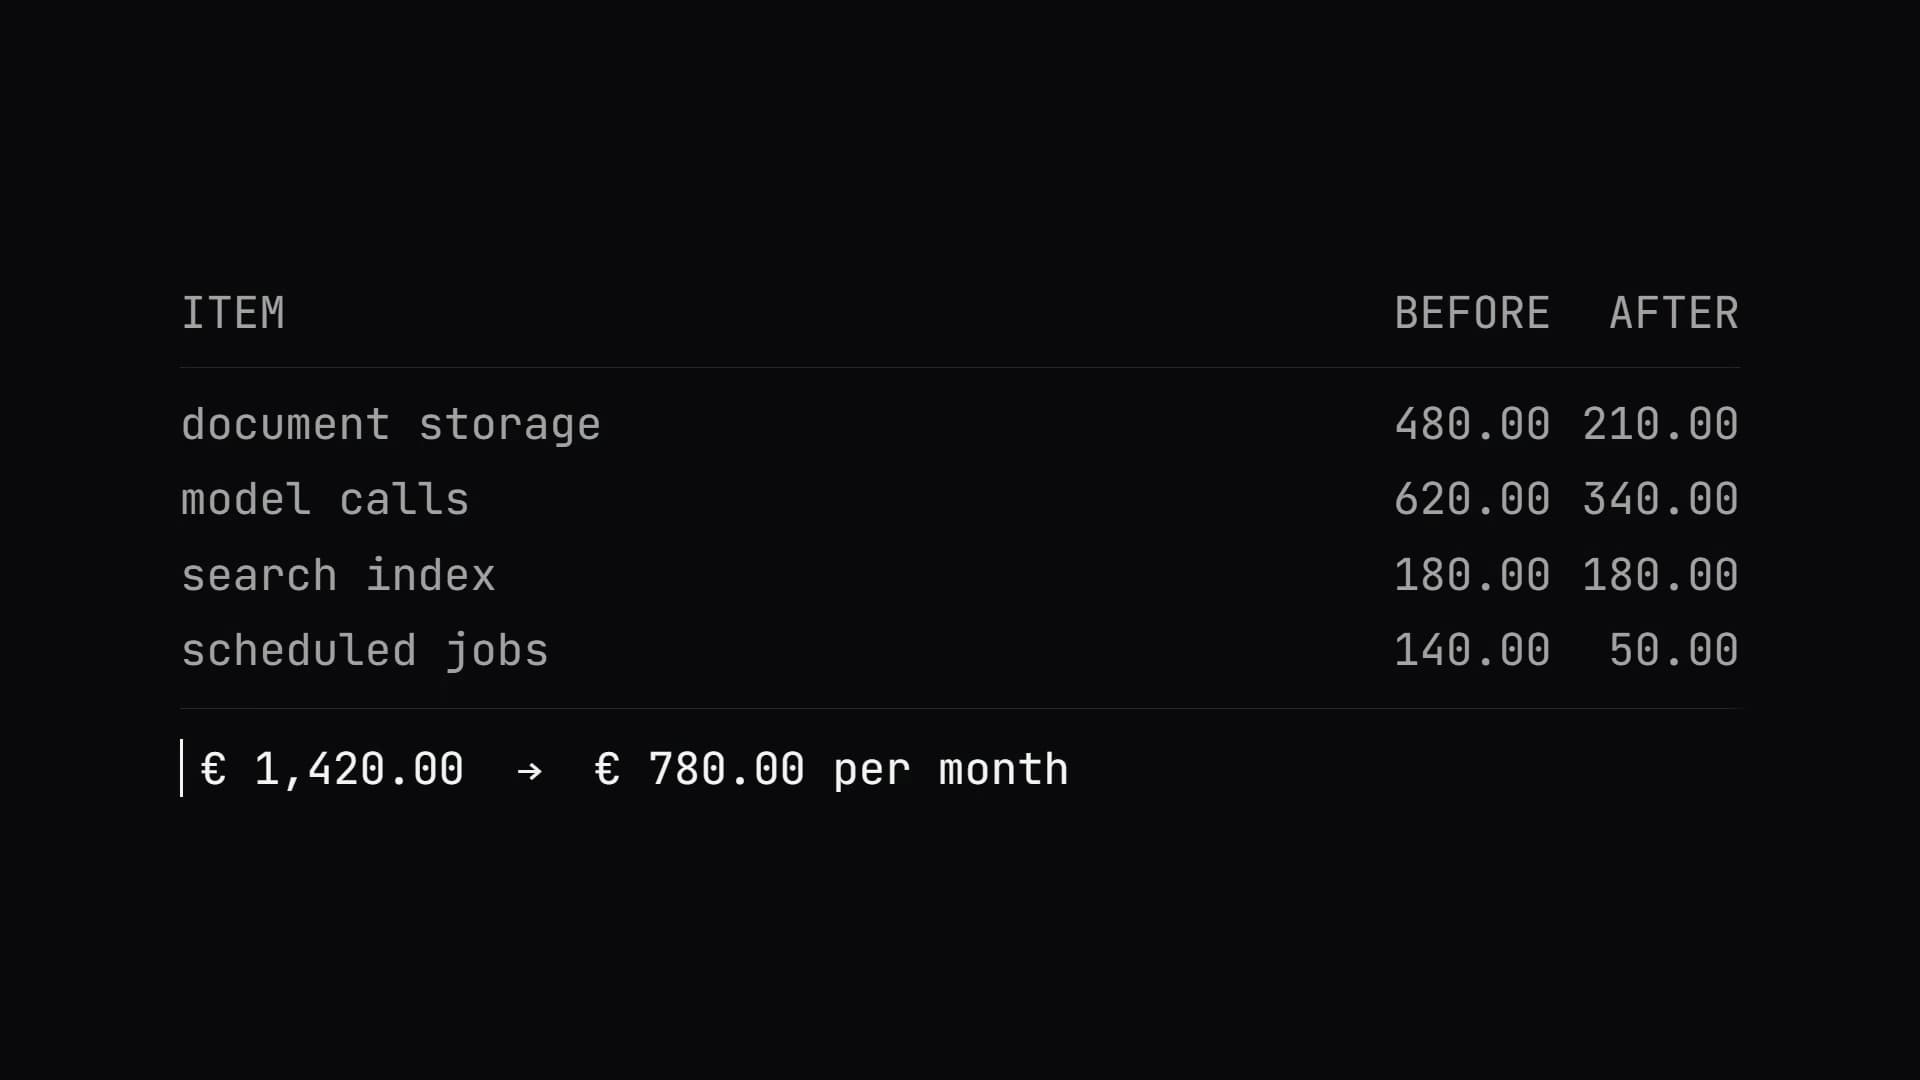
Ablösung von KI-SaaS durch integrierte Eigenentwicklung
 KI-generiert
Der Stack: pgvector, RAG, HNSW
Nach Ausgangslage und Arbeitsweise fragt niemand mehr, was installiert ist — sondern ob davon etwas echt ist. Die Zeile bleibt, zwei Rahmen darunter antworten.
Claude GPT Gemini pgvector PostgreSQL Python Node Docker Twilio RAG HNSW
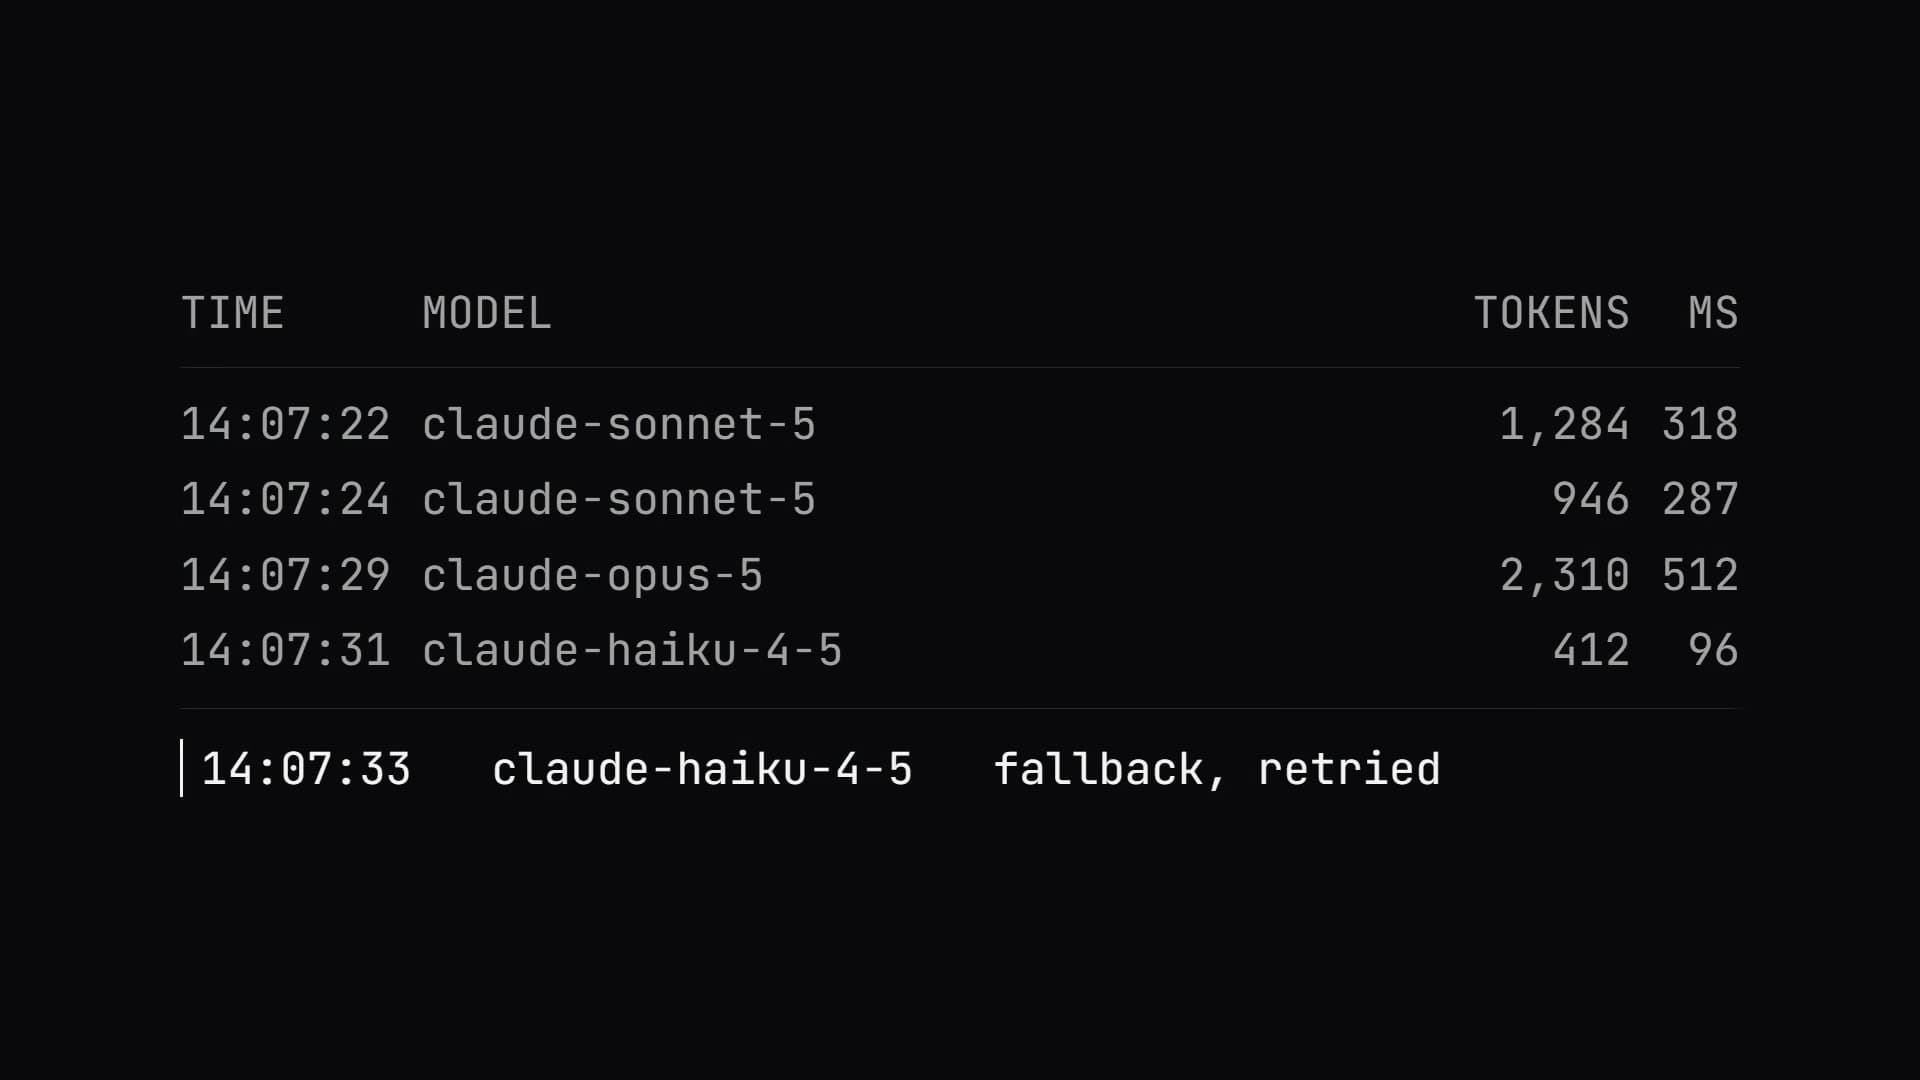
Im Betrieb
 KI-generiert
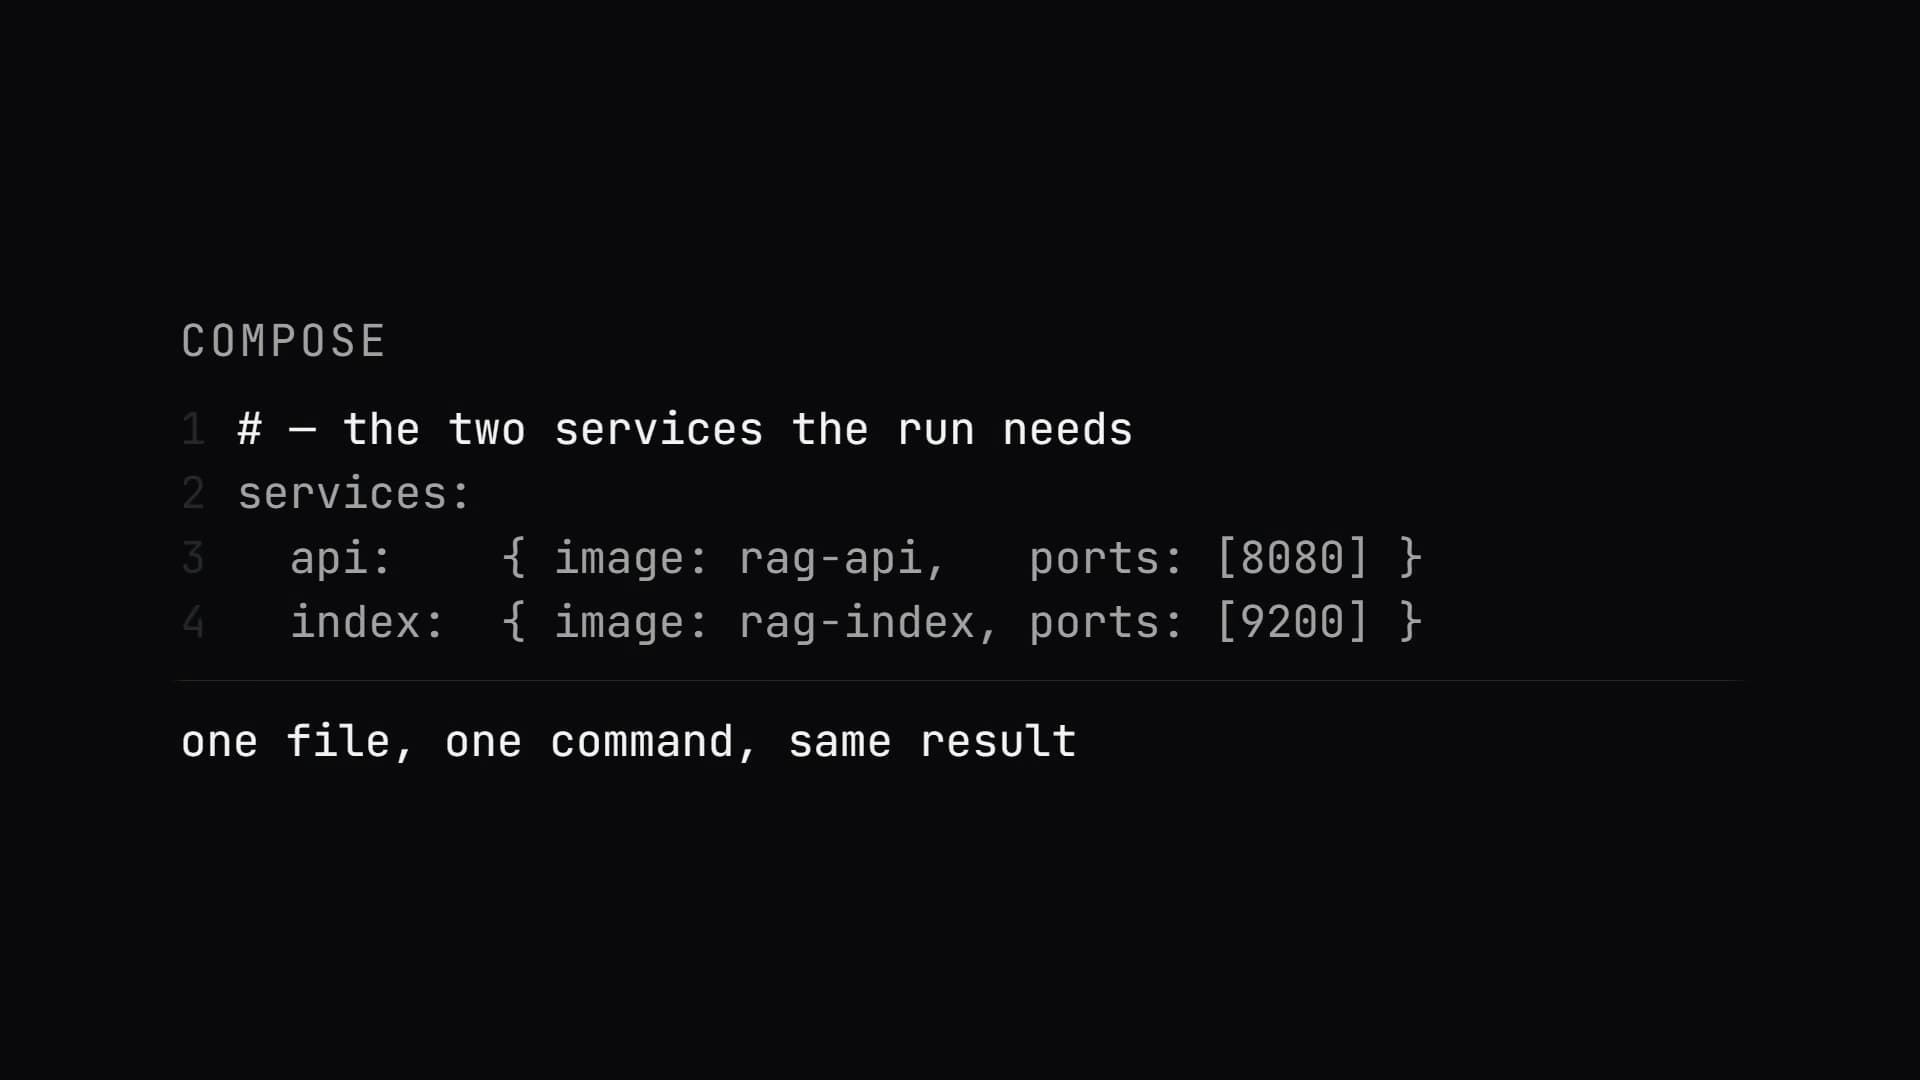
Wiederholbar
 KI-generiert
Größenordnung
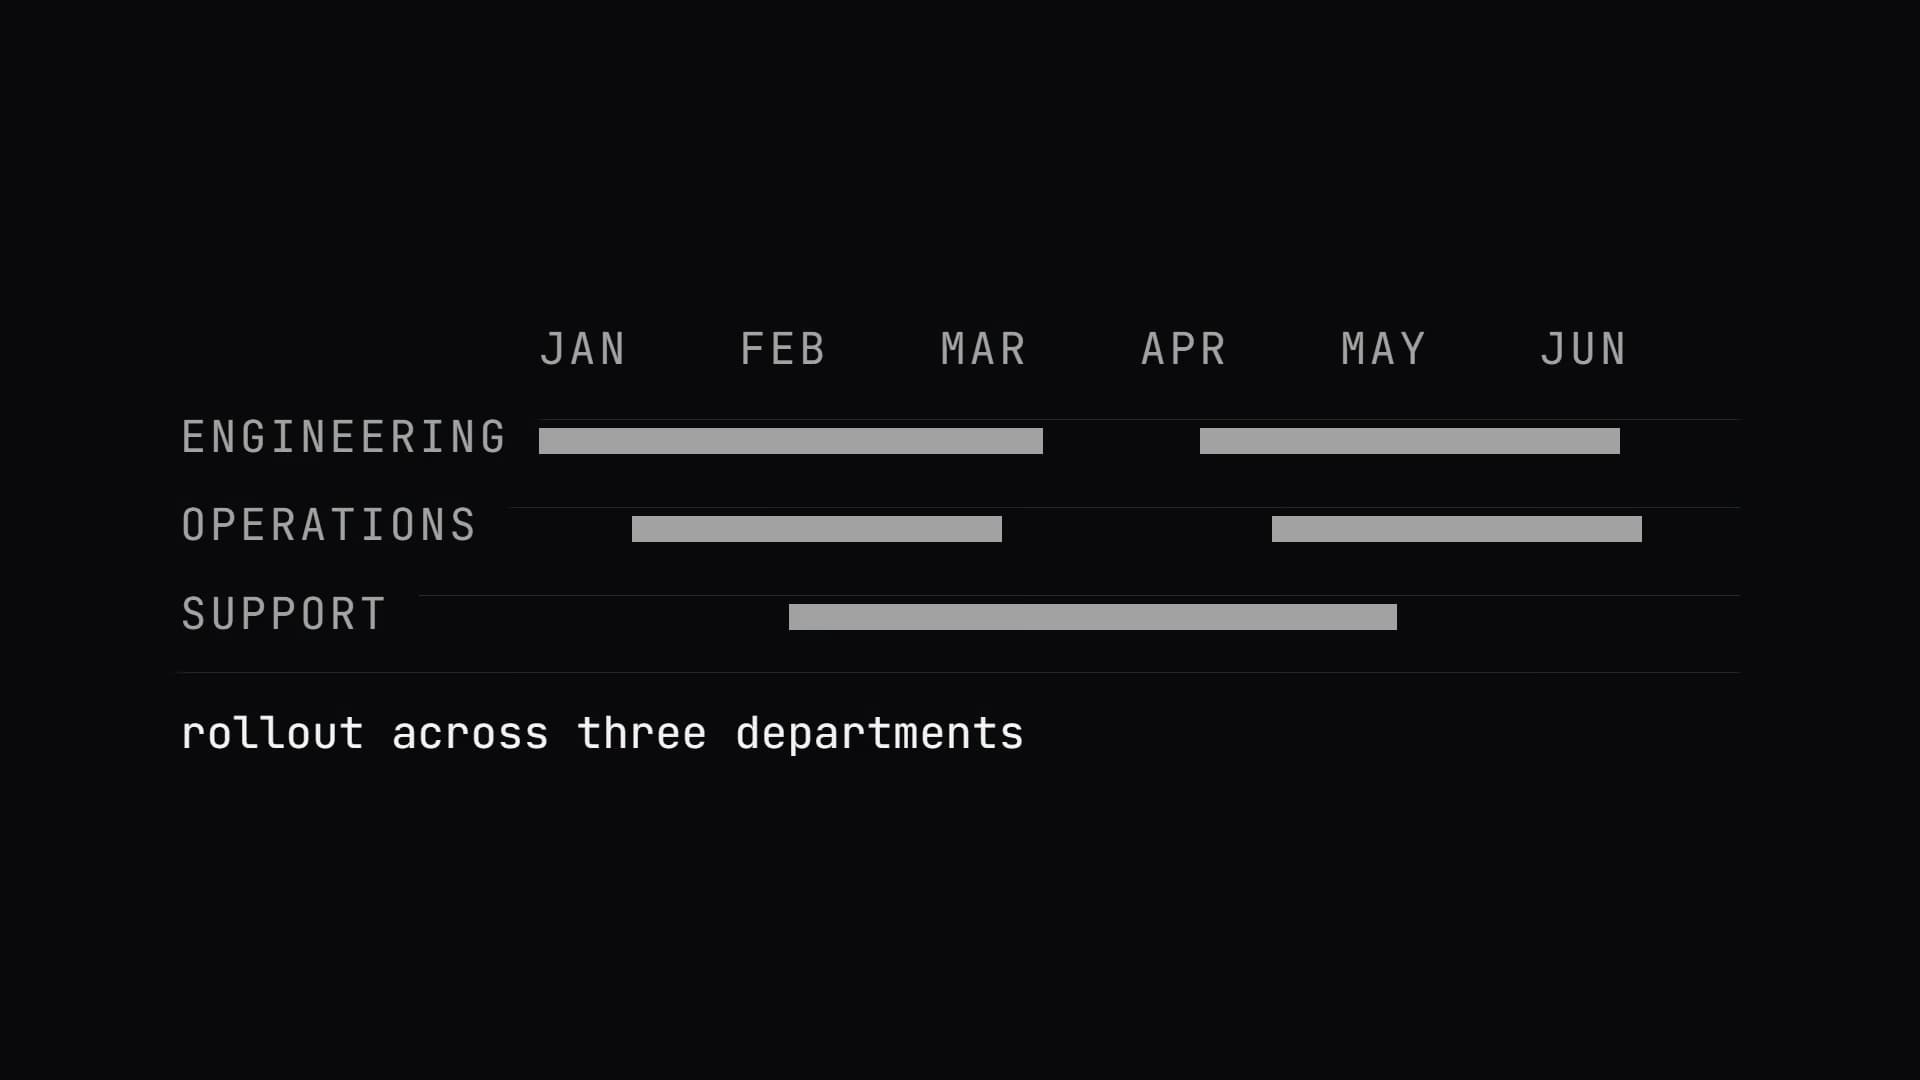
Klein hieß: ein Skript, das ab Freitag Rechnungs-Mails sortiert. Groß hieß: Suche und Assistenz über 14.000 Dokumente und drei Abteilungen — der Aufwand steckte in den Sonderfällen.
 KI-generiert
 KI-generiert
Häufige Fragen
Fünf Fragen, die zu diesem Bereich regelmäßig kommen — beantwortet aus den Projekten, in denen sie aufkamen.
- Was ist RAG, und wann ist es einem Chatbot vorzuziehen?
- RAG heißt: erst in den Dokumenten suchen, dann das Modell mit dem Fund antworten lassen. Es ist die richtige Bauform, sobald die Antwort in den eigenen Unterlagen steht und nicht im Weltwissen des Modells.
- Wo lagen die Dokumente — im eigenen Haus oder beim Modellanbieter?
- Der Index lag in der PostgreSQL des Kunden. An das Modell ging nur der Ausschnitt, den die Frage braucht — und wo auch das zu viel war, lief das Modell auf der eigenen Maschine.
- Wie viele Dokumente verträgt eine Vektorsuche mit pgvector?
- 14.000 Dokumente über drei Abteilungen laufen produktiv, mit HNSW als Index. Die Grenze ist in der Praxis nicht die Zahl der Dokumente, sondern wie sauber sie geschnitten sind.
- Woran wurde gemessen, ob die Suche gut genug ist?
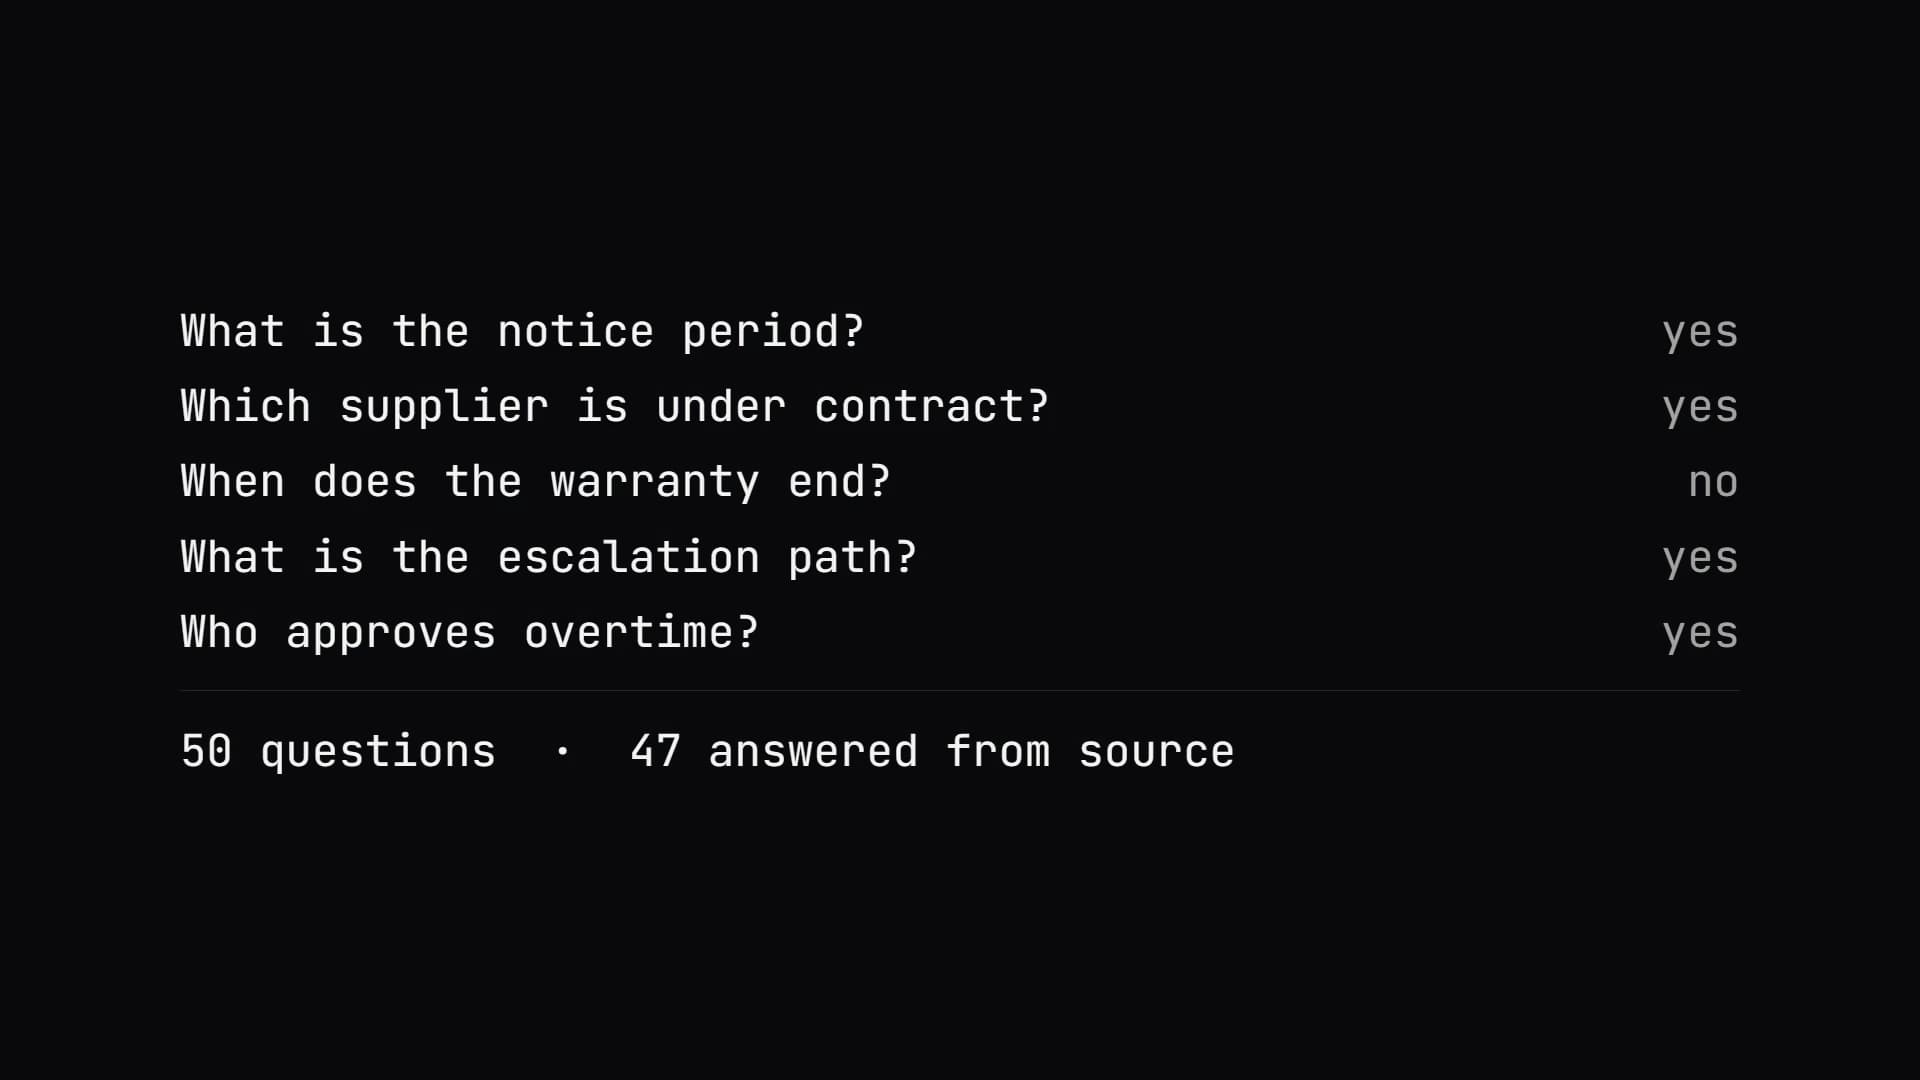
- An echten Fragen aus dem Alltag, nicht an einer Demo. Das Testset bestand aus Fragen, die tatsächlich gestellt wurden; unter 90 % Treffer@3 ging nichts in Betrieb.
- Braucht es eine eigene Vektordatenbank wie Pinecone?
- Selten. pgvector sitzt in der Datenbank, die ohnehin läuft — ein System weniger, ein Backup weniger, eine Rechnung weniger. Ab dreistelligen Millionen Vektoren sieht das anders aus.